人工智能的第三次浪潮离不开卷积神经网络的发展,Pytorch是一个非常好的深度学习框架,而在
Pytorch中,一般采用torch.nn模块来构建神经网络。
Pytorch 神经网络构建
在Pytorch中,一般采用torch.nn模块来构建神经网络,torch.nn模块是专门为神经网络设计的模块,它包含了构建神经网络所需要的所有组件,我们只需要继承torch.nn.Module类,然后实现forward方法即可。
简单实现
下面是一个简单的神经网络实现的例子:
import torch
import torch.nn as nn
import torch.nn.functional as F

"""
神经网络构造

"""

class MLP(nn.Module):
    # 声明带有模型参数的层,这里声明了两个全连接层
    # __init__是Python的构造函
    def __init__(self, **kwargs):
        # 调用MLP父类Block的构造函数来进行必要的初始化。这样在构造实例时还可以指定其他函数
        super(MLP, self).__init__(**kwargs)
        self.hidden = nn.Linear(784, 256)
        self.act = nn.ReLU()
        self.output = nn.Linear(256, 10)

    # 定义模型的前向计算,即如何根据输入x计算返回所需要的模型输出
    def forward(self, x):
        o = self.act(self.hidden(x))
        return self.output(o)


X = torch.rand(2, 784)  # 设置一个随机的输入张量
net = MLP()  # 实例化模型
print(X)
print(net)  # 打印模型
print(net(X)) # 前向计算输出结果如下:
tensor([[0.9963, 0.6040, 0.0329,  ..., 0.1270, 0.5267, 0.9478],
        [0.8704, 0.4513, 0.9241,  ..., 0.0011, 0.4864, 0.9921]])
MLP(
  (hidden): Linear(in_features=784, out_features=256, bias=True)
  (act): ReLU()
  (output): Linear(in_features=256, out_features=10, bias=True)
)
tensor([[-2.8145e-02,  3.5952e-02,  3.1102e-02,  2.9274e-03, -1.0772e-01,
         -1.3875e-01, -7.6061e-04, -4.6140e-02,  1.3985e-01,  6.7726e-02],
        [-6.1352e-05, -3.9309e-02, -3.1205e-02, -1.3300e-02,  9.6050e-02,
         -1.9969e-01,  5.8465e-02, -9.1572e-02,  1.1360e-01, -3.7201e-02]],
grad_fn=<AddmmBackward0>)在上面的例子中,MLP类继承了torch.nn.Module类,然后实现了__init__和forward方法,__init__方法用于初始化模型参数,forward方法用于定义模型的前向计算。
常见的神经网络层
关于卷积和池化以及全连接作用可参考样本不均衡条件下交通标志检测方法研究3
在实际的神经网络中,我们一般会使用一些常见的神经网络层,比如全连接层、卷积层、池化层等,Pytorch中提供了这些常见的神经网络层,我们可以直接使用,但是很多时候我们也需要自定义一些神经网络层,这时我们可以继承torch.nn.Module类,然后实现forward方法。
torch.nn.Linear:全连接层
torch.nn.Linear(in_features, out_features, bias=True) in_features:输入特征维度,out_features:输出特征维度,bias:是否使用偏置。
全连接层的主要作用就是将前层(卷积、池化等层)计算得到的特征空间映射样本标记空间。简单的说就是将特征表示整合成一个值,其优点在于减少特征位置对于分类结果的影响,提高了整个网络的鲁棒性。 全连接在整个网络卷积神经网络中起到“分类器”的作用,如果说卷积层、池化层和激活函数等操作是将原始数据映射到隐层特征空间的话,全连接层则起到将学到的特征表示映射到样本的标记空间的作用。其实,就是把特征整合到一起,方便交给最后的分类器或者回归。
import torch
import torch.nn as nn

# 定义一个全连接层,输入特征维度为4,输出特征维度为3
layer = nn.Linear(4, 3)
# 输入特征维度为2
input = torch.randn(2, 4)
# 输出特征维度为2
output = layer(input)
print(output)torch.nn.Conv2d:卷积层
torch.nn.Conv2d(in_channels, out_channels, kernel_size, stride=1, padding=0, dilation=1, groups=1, bias=True) in_channels:输入通道数,out_channels:输出通道数,kernel_size:卷积核大小,stride:步长,padding:填充,dilation:扩张,groups:分组卷积,bias:是否使用偏置。
卷积的本质就是用卷积核的参数来提取原始数据的特征,通过矩阵点乘的运算,提取出和卷积核特征一致的值,如果卷积层有多个卷积核,则神经网络会自动学习卷积核的参数值,使得每个卷积核代表一个特征。
import torch
import torch.nn as nn

# 定义一个卷积层,输入通道数为3,输出通道数为16,卷积核大小为3x3
layer = nn.Conv2d(3, 16, kernel_size=3)
# 输入特征维度为2
input = torch.randn(2, 3, 32, 32)
# 输出特征维度为2
output = layer(input)
print(output.size())
print(output)torch.nn.MaxPool2d:最大池化层
torch.nn.MaxPool2d(kernel_size, stride=None, padding=0, dilation=1, return_indices=False, ceil_mode=False) kernel_size:池化核大小,stride:步长,padding:填充,dilation:扩张,return_indices:是否返回索引,ceil_mode:是否向上取整。
池化层的作用是对特征图进行降维,减少参数数量,提高计算速度,同时也可以提高模型的鲁棒性,防止过拟合,在图像识别中,一般采用最大池化,即取池化核中的最大值。
import torch
import torch.nn as nn

# 定义一个最大池化层,池化核大小为2x2
layer = nn.MaxPool2d(kernel_size=2)
# 输入特征维度为2
input = torch.randn(2, 3, 32, 32)
# 输出特征维度为2
output = layer(input)
print(output.size())
print(output)torch.nn.ReLU:激活函数
torch.nn.ReLU(inplace=False) inplace:是否原地操作。
激活函数是非线性的函数,其不改变数据的尺寸,但对输入的数据值进行变换。类似人类神经元,当输入电信号达到一定程度则会激活,激活函数对于不同大小的输入,输出值应当可体现激活和抑制的区别。
这里将在后面的笔记中扩充激活函数的详细内容
import torch
import torch.nn as nn

# 定义一个激活函数
layer = nn.ReLU()
# 输入特征维度为2
input = torch.randn(2, 3, 32, 32)
# 输出特征维度为2
output = layer(input)
print(output.size())
print(output)- 自定义不含模型参数的层
通过继承Module类自定义`将输入减掉均值后输出的层,并将层的计算定义在了 forward 函数里。
import torch
from torch import nn

# 自定义一个层,不含模型参数
class CenteredLayer(nn.Module):
    # 构造函数,__init__是构造函数
    def __init__(self, **kwargs):
        super(CenteredLayer, self).__init__(**kwargs)
    # 前向计算函数
    def forward(self, x):
        return x - x.mean()

layer = CenteredLayer()
print(layer(torch.tensor([1, 2, 3, 4, 5], dtype=torch.float)))- 自定义含模型参数的层
通过继承Module类自定义含模型参数的层,这里定义一个含模型参数的层,其中的模型参数是一个可以学习的参数,通过Parameter类创建。
import torch
from torch import nn

# 自定义一个含模型参数的层
class MyDense(nn.Module):
    # 构造函数
    def __init__(self):
        super(MyDense, self).__init__()
        # 参数初始化
        self.params = nn.ParameterList([nn.Parameter(torch.randn(4, 4)) for i in range(3)])
        self.params.append(nn.Parameter(torch.randn(4, 1)))
    # 前向计算函数
    def forward(self, x):
        for i in range(len(self.params)):
            x = torch.mm(x, self.params[i])
        return x

net = MyDense()
print(net)模型基础实现
下面介绍两种基础的神经网络,分别是LeNet和AlexNet。
前馈神经网络(feed-forward network , LeNet)
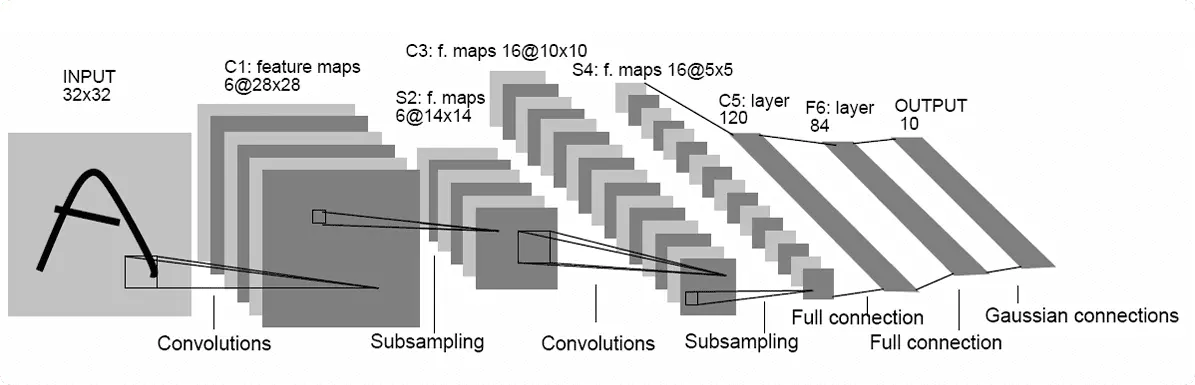
其实现流程如下:
C1 层是卷积层,使用 6 个 5×5 大小的卷积核,padding=0,stride=1进行卷积,得到 6 个 28×28 大小的特征图:32-5+1=28 。
S2 层是池化层,使用 2×2 大小的池化核,padding=0,stride=2进行池化,得到 6 个 14×14 大小的特征图:(28-2)/2+1=14 。
C3 层是卷积层,使用 16 个 5×5 大小的卷积核,padding=0,stride=1进行卷积,得到 16 个 10×10 大小的特征图:14-5+1=10 。
S4 层是池化层,使用 2×2 大小的池化核,padding=0,stride=2进行池化,得到 16 个 5×5 大小的特征图:(10-2)/2+1=5 。
C5 层是卷积层,使用 120 个 5×5 大小的卷积核,padding=0,stride=1进行卷积,得到 120 个 1×1 大小的特征图:5-5+1=1 ,也就是相当于120个神经元的全连接层。
F6 层是全连接层,输入特征维度为 120,输出特征维度为 84
OUTPUT 层是全连接层,输入特征维度为 84,采用了 RBF 函数(即径向欧式距离函数),计算输入向量和参数向量之间的欧式距离(目前已经被Softmax 取代)。
上面的流程看起来有些许复杂,简单来说,一个神经网络典型训练过程应该是:
定义包含可学习参数(或者权重)的神经网络。
在数据集上迭代。
通过神经网络处理输入。
计算损失(输出结果和正确值之间的距离)。
将梯度反向传播回网络的参数。
更新网络的参数,通常使用一个简单的更新规则:
weight = weight - learning_rate * gradient。
使用Pytorch我们可以很方便的实现上面的流程,下面是一个简单的实现:
import torch
import torch.nn as nn
import torch.nn.functional as F

# 定义一个卷积神经网络类 LeNet,继承自 nn.Module
class LeNet(nn.Module):
    def __init__(self):
        super(LeNet, self).__init__()
        # 定义第一个卷积层,输入通道数为1,输出通道数为6,卷积核大小为5x5
        self.conv1 = nn.Conv2d(1, 6, 5)
        # 定义第二个卷积层,输入通道数为6,输出通道数为16,卷积核大小为5x5
        self.conv2 = nn.Conv2d(6, 16, 5)
        # 定义第一个全连接层,输入特征数为16*5*5,输出特征数为120
        self.fc1 = nn.Linear(16 * 5 * 5, 120)
        # 定义第二个全连接层,输入特征数为120,输出特征数为84
        self.fc2 = nn.Linear(120, 84)
        # 定义第三个全连接层,输入特征数为84,输出特征数为10
        self.fc3 = nn.Linear(84, 10)

    # 定义前向传播函数
    def forward(self, x):
        # 通过第一个卷积层和激活函数ReLU,然后进行2x2的最大池化
        x = F.max_pool2d(F.relu(self.conv1(x)), (2, 2))
        # 通过第二个卷积层和激活函数ReLU,然后进行2x2的最大池化
        x = F.max_pool2d(F.relu(self.conv2(x)), 2)
        # 将特征图展平为一维向量
        x = x.view(-1, self.num_flat_features(x))
        # 通过第一个全连接层和激活函数ReLU
        x = F.relu(self.fc1(x))
        # 通过第二个全连接层和激活函数ReLU
        x = F.relu(self.fc2(x))
        # 通过第三个全连接层
        x = self.fc3(x)
        return x

    # 计算展平后的特征数
    def num_flat_features(self, x):
        size = x.size()[1:]  # 除去批量大小的其他维度
        num_features = 1
        for s in size:
            num_features *= s  # 计算所有维度的乘积
        return num_features

# 创建 LeNet 网络实例
net = LeNet()
print(net)

print('可学习参数:')
for name, param in net.named_parameters():
    print(name, param.size())

# 随机生成一个输入样本
input = torch.randn(1, 1, 32, 32)
# 通过网络进行前向传播
out = net(input)
print(out)注意 torch.nn仅支持mini-batches,不支持一次只输入一个样本,即一次必须是一个batch。但如果只想输入一个样本,则用input.unsqueeze(0)将batch_size设为1。
深度卷积神经网络(AlexNet)
原论文:ImageNet Classification with Deep Convolutional Neural Networks
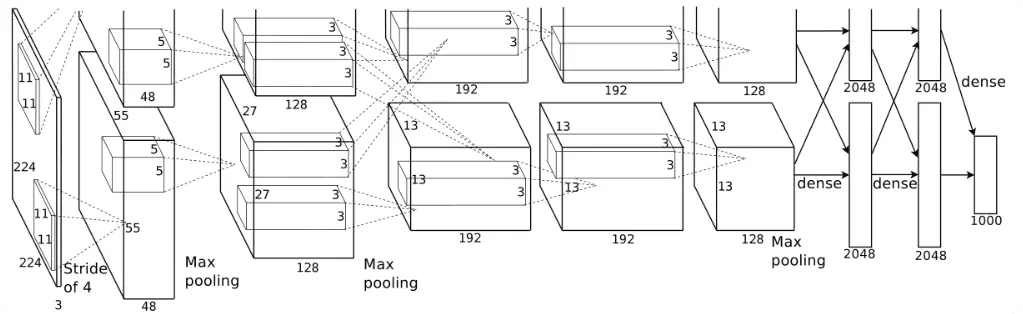
这张图因为包含了两个GPU,且图例中包含了GPU通信的部分,所以看起来比较复杂,简化后的结构如下:
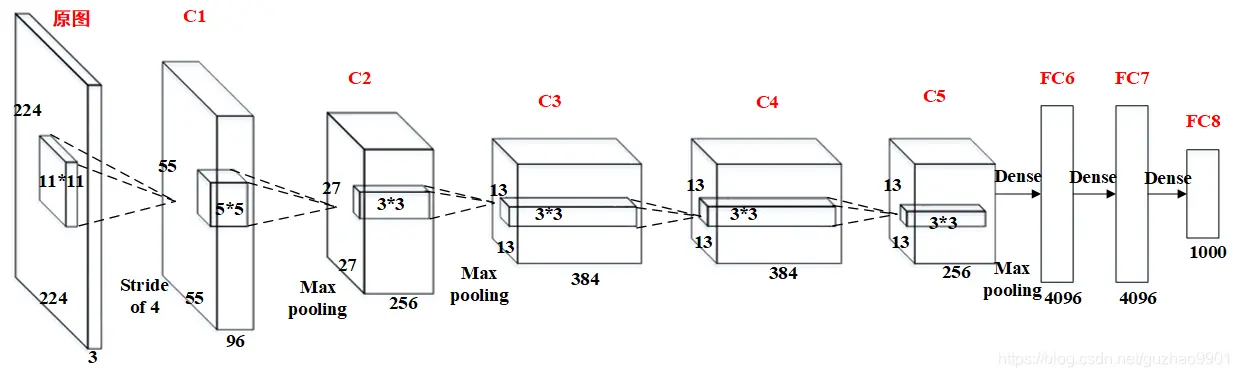
其实现流程如下:
原图输入224 × 224,实际上进行了随机裁剪,实际大小为227 × 227。
卷积层C1,C1的基本结构为:卷积–>ReLU–>池化
卷积:输入227 × 227 × 3,96个11×11×3的卷积核,不扩充边缘padding = 0,步长stride = 4,因此其FeatureMap大小为(227-11+0×2+4)/4 = 55,即55×55×96;
激活函数:ReLU;
池化:池化核大小3 × 3,不扩充边缘padding = 0,步长stride = 2,因此其FeatureMap输出大小为(55-3+0×2+2)/2=27, 即C1输出为27×27×96(此处未将输出分到两个GPU中,若按照论文将分成两组,每组为27×27×48);
卷积层C2,C2的基本结构为:卷积–>ReLU–>池化
卷积:输入27×27×96,256个5×5×96的卷积核,扩充边缘padding = 2, 步长stride = 1,因此其FeatureMap大小为(27-5+2×2+1)/1 = 27,即27×27×256;
激活函数:ReLU;
池化:池化核大小3 × 3,不扩充边缘padding = 0,步长stride = 2,因此其FeatureMap输出大小为(27-3+0+2)/2=13, 即C2输出为13×13×256(此处未将输出分到两个GPU中,若按照论文将分成两组,每组为13×13×128);
卷积层C3,C3的基本结构为:卷积–>ReLU。注意一点:此层没有进行MaxPooling操作。
卷积:输入13×13×256,384个3×3×256的卷积核, 扩充边缘padding = 1,步长stride = 1,因此其FeatureMap大小为(13-3+1×2+1)/1 = 13,即13×13×384;
激活函数:ReLU,即C3输出为13×13×384(此处未将输出分到两个GPU中,若按照论文将分成两组,每组为13×13×192);
卷积层C4,C4的基本结构为:卷积–>ReLU。注意一点:此层也没有进行MaxPooling操作。
卷积:输入13×13×384,384个3×3×384的卷积核, 扩充边缘padding = 1,步长stride = 1,因此其FeatureMap大小为(13-3+1×2+1)/1 = 13,即13×13×384;
激活函数:ReLU,即C4输出为13×13×384(此处未将输出分到两个GPU中,若按照论文将分成两组,每组为13×13×192);
卷积层C5,C5的基本结构为:卷积–>ReLU–>池化
卷积:输入13×13×384,256个3×3×384的卷积核,扩充边缘padding = 1,步长stride = 1,因此其FeatureMap大小为(13-3+1×2+1)/1 = 13,即13×13×256;
激活函数:ReLU;
池化:池化核大小3 × 3, 扩充边缘padding = 0,步长stride = 2,因此其FeatureMap输出大小为(13-3+0×2+2)/2=6, 即C5输出为6×6×256(此处未将输出分到两个GPU中,若按照论文将分成两组,每组为6×6×128);
全连接层FC6,FC6的基本结构为:全连接–>>ReLU–>Dropout
全连接:此层的全连接实际上是通过卷积进行的,输入6×6×256,4096个6×6×256的卷积核,扩充边缘padding = 0, 步长stride = 1, 因此其FeatureMap大小为(6-6+0×2+1)/1 = 1,即1×1×4096;
激活函数:ReLU;
Dropout:全连接层中去掉了一些神经节点,达到防止过拟合,FC6输出为1×1×4096;
全连接层FC7,FC7的基本结构为:全连接–>>ReLU–>Dropout
全连接:此层的全连接,输入1×1×4096;
激活函数:ReLU;
Dropout:全连接层中去掉了一些神经节点,达到防止过拟合,FC7输出为1×1×4096;
全连接层FC8,FC8的基本结构为:全连接–>>softmax
全连接:此层的全连接,输入1×1×4096;
softmax:softmax为1000,FC8输出为1×1×1000;
下面,我们使用Pytorch实现AlexNet:
import torch
import torch.nn as nn
import torch.nn.functional as F

# 定义一个卷积神经网络类 AlexNet,继承自 nn.Module
class AlexNet(nn.Module):
    def __init__(self):
        super(AlexNet, self).__init__()
        # 定义第一个卷积层,输入通道数为3,输出通道数为96,卷积核大小为11x11
        self.conv1 = nn.Conv2d(3, 96, 11, stride=4)
        # 定义第二个卷积层,输入通道数为96,输出通道数为256,卷积核大小为5x5
        self.conv2 = nn.Conv2d(96, 256, 5, padding=2)
        # 定义第三个卷积层,输入通道数为256,输出通道数为384,卷积核大小为3x3
        self.conv3 = nn.Conv2d(256, 384, 3, padding=1)
        # 定义第四个卷积层,输入通道数为384,输出通道数为384,卷积核大小为3x3
        self.conv4 = nn.Conv2d(384, 384, 3, padding=1)
        # 定义第五个卷积层,输入通道数为384,输出通道数为256,卷积核大小为3x3
        self.conv5 = nn.Conv2d(384, 256, 3, padding=1)
        # 定义第一个全连接层,输入特征数为256*6*6,输出特征数为4096
        self.fc1 = nn.Linear(256 * 6 * 6, 4096)
        # 定义第二个全连接层,输入特征数为4096,输出特征数为4096
        self.fc2 = nn.Linear(4096, 4096)
        # 定义第三个全连接层,输入特征数为4096,输出特征数为1000
        self.fc3 = nn.Linear(4096, 1000)

    # 定义前向传播函数
    def forward(self, x):
        # 通过第一个卷积层和激活函数ReLU,然后进行2x2的最大池化
        x = F.max_pool2d(F.relu(self.conv1(x)), (3, 3), stride=2)
        # 通过第二个卷积层和激活函数ReLU,然后进行2x2的最大池化
        x = F.max_pool2d(F.relu(self.conv2(x)), (3, 3), stride=2)
        # 通过第三个卷积层和激活函数ReLU
        x = F.relu(self.conv3(x))
        # 通过第四个卷积层和激活函数ReLU
        x = F.relu(self.conv4(x))
        # 通过第五个卷积层和激活函数ReLU,然后进行2x2的最大池化
        x = F.max_pool2d(F.relu(self.conv5(x)), (3, 3), stride=2)
        # 将特征图展平为一维向量
        x = x.view(-1, self.num_flat_features(x))
        # 通过第一个全连接层和激活函数ReLU
        x = F.relu(self.fc1(x))
        # 通过第二个全连接层和激活函数ReLU
        x = F.relu(self.fc2(x))
        # 通过第三个全连接层
        x = self.fc3(x)
        return x

    # 计算展平后的特征数
    def num_flat_features(self, x):
        size = x.size()[1:]  # 除去批量大小的其他维度
        num_features = 1
        for s in size:
            num_features *= s  # 计算所有维度的乘积
        return num_features

# 创建 AlexNet 网络实例
net = AlexNet()
print(net)

print('可学习参数:')
for name, param in net.named_parameters():
    print(name, param.size())

# 随机生成一个输入样本
input = torch.randn(1, 3, 227, 227)
# 通过网络进行前向传播
out = net(input)
print(out)