目标检测理论
卷积神经网络(CNN)
是一种专门用于图像处理的神经网络,通过卷积操作和池化操作来提取图像的特征,然后通过全连接层进行分类。因其工作流程和人脑神界的工作流程相似,卷积神经网络时深度学习中最常见的网络,主要由卷积层、池化层、批量归一化层以及全连接层组成。卷积层
以下内容图片引用自CSDN-卷积神经网络 (CNN) 基本原理和公式用以解释卷积层的基本原理。
卷积层是卷积神经网络的核心层,通过卷积操作提取图像的特征。卷积操作是一种有效的特征提取方法,可以提取图像的局部特征,保留图像的空间结构信息。 卷积运算用"*"表示,卷积操作的数学表达式如下:
其中,
对于一张输入图片, 将其转化为矩阵, 矩阵的元素为对应的像素值. 假设有一个 5 × 5 的输入图片, 一个 3 × 3 的卷积核,那么卷积操作的结果为一个 3 × 3 的输出特征图。
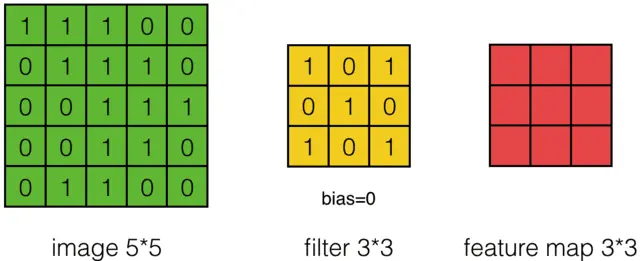
操作示例图如下:
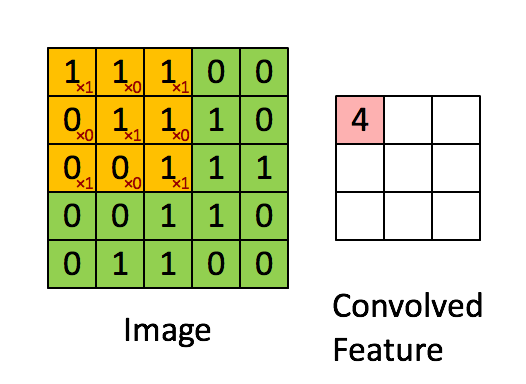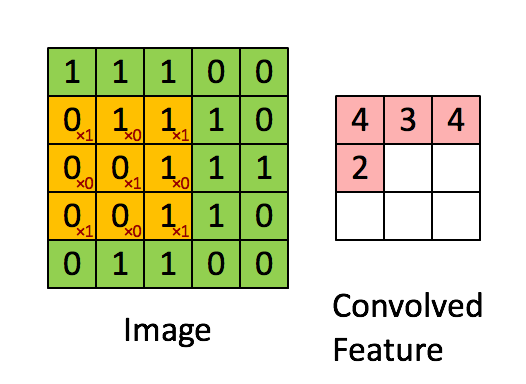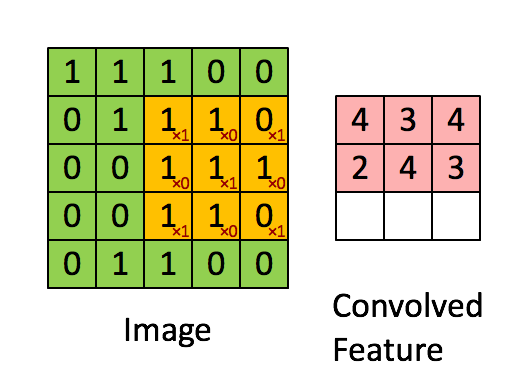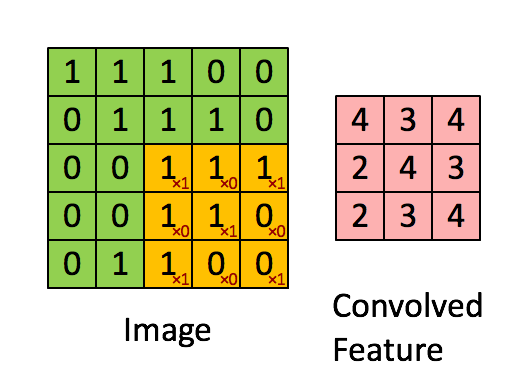
黄色的区域表示卷积核在输入矩阵中滑动, 每滑动到一个位置, 将对应数字相乘并求和, 得到一个特征图矩阵的元素. 注意到, 动图中卷积核每次滑动了一个单位, 实际上滑动的幅度可以根据需要进行调整. 如果滑动步幅大于 1, 则卷积核有可能无法恰好滑到边缘, 针对这种情况, 可在矩阵最外层补零。
有了以上的基础知识, 我们可以开始讨论目标检测的相关内容。
池化层
由上面对卷积层介绍可知,卷积层可以获得更有效的图像特征信息,但是这些特征信息中不仅含有待检测目标的特征信息,还参杂了对检测目标无关的信息。因此,需要对卷积层提取的特征图进行降维处理,以减少特征图的维度,提高计算效率。就是用来实现这一目的的。而池化层则是完成这一目的的。
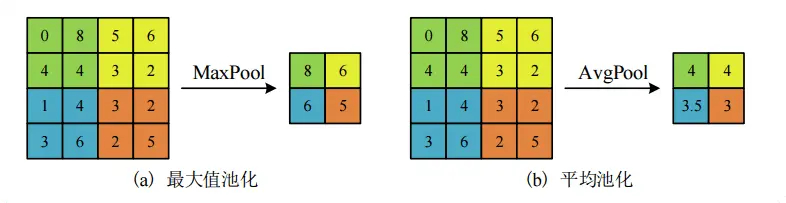
常用的池化操作有最大池化和平均池化,其中最大池化是取池化窗口中的最大值作为输出,平均池化是取池化窗口中的平均值作为输出。
最大池化相比于平均池化,在有着降低维度的功能同时,也有能够一致特征图噪声的功能。因此一般卷积神经网络都选择使用最大池化操作。
示例图如下:
概念解释
- 池化层:池化层是卷积神经网络的一种层,用于对卷积层提取的特征图进行降维处理,以减少特征图的维度,提高计算效率。
批量归一化层
使用浅层模型时,随着模型训练的进行,当每层中参数更新时,靠近输出层的输出较难出现剧烈变化。对深层神经网络来说,随着网络训练的进行,前一层参数的调整使得后一层输入数据的分布发生变化,各层在训练的过程中就需要不断的改变以适应学习这种新的数据分布。所以即使输入数据已做标准化,训练中模型参数的更新依然很容易导致后面层输入数据分布的变化,只要网络的前面几层发生微小的改变,那么后面几层就会被累积放大下去。最终造成靠近输出层输出的剧烈变化。这种计算数值的不稳定性通常令我们难以训练出有效的深度模型。如果训练过程中,训练数据的分布一直在发生变化,那么将不仅会增大训练的复杂度,影响网络的训练速度而且增加了过拟合的风险。
在模型训练时,在应用激活函数之前,先对一个层的输出进行归一化,将所有批数据强制在统一的数据分布下,然后再将其输入到下一层,使整个神经网络在各层的中间输出的数值更稳定。从而使深层神经网络更容易收敛而且降低模型过拟合的风险。
全连接层
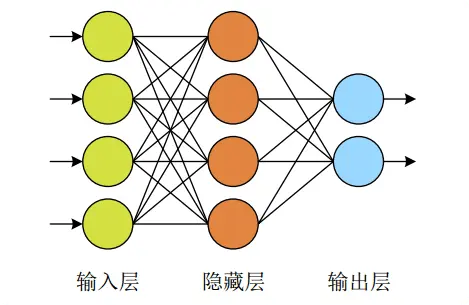
是卷积神经网络的最后一层,用于将卷积层和池化层提取的特征图进行分类。全连接层的神经元与上一层的所有神经元相连,通过权重和偏置进行计算,得到最终的分类结果。结构如下:
优化算法
卷积神经网络的训练过程是一个优化问题,需要通过优化算法来调整网络参数,使得网络的损失函数最小。常用的优化算法有、、和自适应矩估计(Adam)等。
SGD 优化算法在计算下降最快的方向时随机选一个样本进行计算,由于其每次迭代仅使用一个样本,而不是扫描全部训练数据集,这样就加快了迭代速度,但每次更新有随机性,并不是每次迭代都向着整体最优化方向,会导致损失函数出现严重抖动情况。
BGD 每次迭代都需要全部训练集数据,若训练的数据集较大,则该算法耗费时间较长,效率低。
MBGD 是 BGD 和 SGD 的折中,每次迭代使用一部分样本进行计算,这样既提高了迭代速度,又保证了迭代的稳定性。
自适应矩估计(Adam)是一种常用的优化算法,它结合了动量法和RMSProp算法,可以自适应地调整学习率,适用于大多数深度学习模型的训练,其梯度下降速度较快,但是容易陷入局部最优解。
概念解释
SGD:随机梯度下降(Stochastic Gradient Descent),是一种常用的优化算法,通过计算损失函数的梯度来调整网络参数,使得网络的损失函数最小。
BGD:批量梯度下降法(Batch Gradient Descent),是一种优化算法,通过计算所有样本的损失函数的梯度来调整网络参数,使得网络的损失函数最小。
MBGD:小批量梯度下降法(Mini-Batch Gradient Descent),是一种优化算法,通过计算一部分样本的损失函数的梯度来调整网络参数,使得网络的损失函数最小。
Adam:自适应矩估计(Adaptive Moment Estimation),是一种常用的优化算法,结合了动量法和RMSProp算法,可以自适应地调整学习率,适用于大多数深度学习模型的训练。
问卷调查
在本篇学习笔记中,在多处使用了AI快捷搜索对话功能,作为读者,你认为这种功能对你的文章阅读有帮助吗?您可点击以下链接参与问卷调查,帮助我们更好地改进产品,本次问卷为有奖问卷,包括PostChat会员和现金奖励,感谢您的参与!点击参与问卷调查