简介
Pytorch是一个开源的深度学习框架,由Facebook开发,提供了动态计算图的机制,使得模型的构建和调试更加灵活和方便。本文将介绍Pytorch的基础知识,包括张量(Tensor)、自动求导(Autograd)和模型构建等内容。
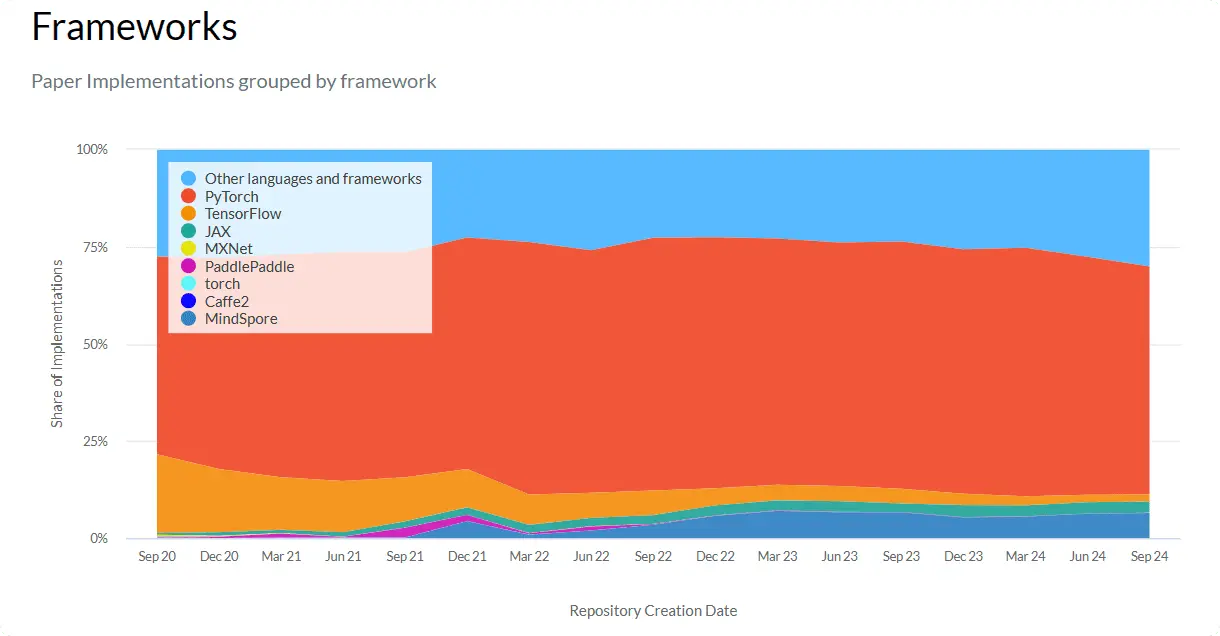 Paper Implementations grouped by framework
截止目前,Pytorch在占有率上已经超过了Tensorflow,成为了最受欢迎的深度学习框架之一。
优势:
简洁,易于使用,封装了很多高级API,方便用户快速构建模型。
强大的社区及生态支持,有大量的开源项目和模型可供使用。
使用CUDA加速,支持NVIDIA GPU的CUDA加速,训练速度快。
特性:
动态计算图(Dynamic Computation Graphs): PyTorch 的计算图是动态的,这意味着它们在运行时构建,并且可以随时改变。这为实验和调试提供了极大的灵活性,因为开发者可以逐行执行代码,查看中间结果。
自动微分(Automatic Differentiation): PyTorch 的自动微分系统允许开发者轻松地计算梯度,这对于训练深度学习模型至关重要。它通过反向传播算法自动计算出损失函数对模型参数的梯度。
张量计算(Tensor Computation): PyTorch 提供了类似于 NumPy 的张量操作,这些操作可以在 CPU 和 GPU 上执行,从而加速计算过程。张量是 PyTorch 中的基本数据结构,用于存储和操作数据。
丰富的 API: PyTorch 提供了大量的预定义层、损失函数和优化算法,这些都是构建深度学习模型的常用组件。
多语言支持: PyTorch 虽然以 Python 为主要接口,但也提供了 C++ 接口,允许更底层的集成和控制。
对于环境配置,可以参考官方文档。
张量(Tensor)
张量是 PyTorch 中的基本数据结构,类似于 NumPy 中的数组。张量可以存储和操作多维数据,支持各种数学运算和线性代数操作。在 PyTorch 中,张量可以在 CPU 和 GPU 上运行,从而加速计算过程。
张量的概念
在数学中:
标量(Scalar):只有一个数值的张量,如 1、2、3 等。
向量(Vector):有多个数值组成的张量,如 [1, 2, 3]。
矩阵(Matrix):二维张量,如 [[1, 2], [3, 4]]。
张量(Tensor):多维张量,如 [[[1, 2], [3, 4]], [[5, 6], [7, 8]]]。
但在 PyTorch 中,张量是一个更加通用的概念,可以是任意维度的数组。
0 维张量:标量(Scalar)。
1 维张量:向量(Vector)。
2 维张量:矩阵(Matrix)。
3 维张量:三维张量,时间序列数据、RGB 图像等。
例:
3维 = 时间序列
4维 = RGB 图像
5维 = 视频
在图像中,一个图像可以用三个维度表示:高度、宽度和通道数。例如,一张 224x224 的 RGB 图像可以表示为一个 3x224x224 的张量。
(width, height, channel) = 3D但是,在机器学习中,我们需要处理大量图片或者文档,也就是说我们需要处理一个集合,这个集合就是一个张量。
(batch_size, width, height, channel) = 4D其中,batch_size 表示一次处理的图片数量。
创建张量
在 PyTorch 中,我们可以使用 torch.Tensor 类来创建张量。张量可以是标量、向量、矩阵或多维张量。
import torch # 导入 PyTorch 库, 如果你不知道这是什么含义,请自行学习Python基础知识

# 创建一个标量(0 维张量)
scalar = torch.tensor(1.0)

# 创建一个向量(1 维张量)
vector = torch.tensor([1.0, 2.0, 3.0])

# 创建一个矩阵(2 维张量)
matrix = torch.tensor([[1.0, 2.0], [3.0, 4.0]])

# 创建一个三维张量
tensor = torch.tensor([[[1.0, 2.0], [3.0, 4.0]], [[5.0, 6.0], [7.0, 8.0]]])

print(scalar)
print(vector)
print(matrix)
print(tensor)可以看到,我们使用 torch.tensor 函数来创建张量,然后打印出来。在 PyTorch 中,张量的数据类型是 torch.Tensor,可以通过 dtype 属相来查看。
类似的,我们还可以使用 torch.zeros、torch.ones、torch.randn 等函数来创建全 0 张量、全 1 张量和随机张量。
import torch

# 创建全 0 张量
zeros = torch.zeros(2, 3) # 2x3 的全 0 张量

# 创建全 1 张量
ones = torch.ones(2, 3)

# 创建随机张量
randn = torch.randn(2, 3)

print(zeros)
print(ones)
print(randn)结果:
tensor([[0., 0., 0.],
        [0., 0., 0.]])
tensor([[1., 1., 1.],
        [1., 1., 1.]])
tensor([[ 1.0898, -0.8992,  1.2634],
[-0.2780, 1.1508, -2.3810]])类似于Matlab和Numpy,Pytorch的Tensor有多种构造方法,以下是常见的方法:
import torch


# 1. 直接构造
a = torch.tensor([[1, 2, 3, 4], [5, 6, 7, 8], [9, 10, 11, 12]])

# 2. 全1构造
b = torch.ones(3, 4)

# 3. 全0构造
c = torch.zeros(3, 4)

# 4. 随机构造 rand/randn
# rand是从0到1的均匀分布,randn是标准正态分布
d = torch.randn(3, 4)

# 5. 从numpy构造
import numpy as np
e = torch.from_numpy(np.array([[1, 2, 3, 4], [5, 6, 7, 8], [9, 10, 11, 12]]))

# 6. 对角为1的构造,其他为0
f = torch.eye(3, 4)

# 7. linspace构造
# torch.linspace(start, end, steps=100) 也就是从start到end,均匀分成step份
g = torch.linspace(1, 10, 10)

# 8. arange构造
# torch.arange(start, end, step=1) 也就是从start到end,间隔为step
h = torch.arange(1, 10, 1)

# 9. normal构造
# torch.normal(mean, std, size) 也就是从均值为mean,标准差为std的正态分布中采样,size是采样的数量
i = torch.normal(0, 1, (3, 4))

# 10. randperm构造
# torch.randperm(n) 也就是生成一个0到n-1的随机排列
j = torch.randperm(10)


print(a)
print(b)
print(c)
print(d)
print(e)
print(f)
print(g)
print(h)
print(i)
print(j)张量的操作
- 基础数学运算,在 PyTorch 中,我们可以对张量进行各种数学运算和线性代数操作,如加法、减法、乘法、除法、矩阵乘法等。
import torch

# 创建两个张量
a = torch.tensor([[1.0, 2.0]
                , [3.0, 4.0]])
b = torch.tensor([[5.0, 6.0]
                , [7.0, 8.0]])

# 加法
c = a + b

# 减法
d = a - b

# 乘法
e = a * b

# 除法
f = a / b

# 矩阵乘法
g = torch.matmul(a, b)

print(c)
print(d)
print(e)
print(f)
print(g)结果:
tensor([[ 6.,  8.],
        [10., 12.]])
tensor([[-4., -4.],
        [-4., -4.]])
tensor([[ 5., 12.],
        [21., 32.]])
tensor([[0.2000, 0.3333],
        [0.4286, 0.5000]])
tensor([[19., 22.],
[43., 50.]])- 索引操作,我们可以使用索引操作来访问张量的元素,类似于 NumPy 中的索引操作。
注意:索引操作结果与原张量共享内存,修改索引操作结果会影响原张量。
例子:
import torch

# 创建一个张量
a = torch.tensor([[1.0, 2.0, 3.0]
                , [4.0, 5.0, 6.0]
                , [7.0, 8.0, 9.0]])

# 访问第一行第一列元素
print(a[0, 0])

# 访问第一行
print(a[0])

# 修改第一行第一列元素
a[0, 0] = 0.0

# 现在,我们来查看原张量
print(a)结果:
tensor(1.)
tensor([1., 2., 3.])
tensor([[0., 2., 3.],
        [4., 5., 6.],
[7., 8., 9.]])- 形状操作,我们可以使用
size()函数来查看张量的形状,使用view()函数来改变张量的形状。
注意:
view()函数返回的张量与原张量本质上是一个张量,只是形状不同,共享内存,相当于同一个数据的不同观察方式,因此操作view()返回的张量会影响原张量。
import torch

# 创建一个张量
a = torch.tensor([[1.0, 2.0, 3.0]
                , [4.0, 5.0, 6.0]
                , [7.0, 8.0, 9.0]])

# 查看张量的形状
print(a.size())

# 改变张量的形状
b = a.view(1, 9) # 改变为 1x9 的张量

print(b)

# 现在,我们试着来修改 b 的值
b[0, 0] = 0.0

# 我们来查看原张量
print(b)
print(a)结果:
torch.Size([3, 3]) // 这里表示3行3列
tensor([[1., 2., 3., 4., 5., 6., 7., 8., 9.]])
tensor([[0., 2., 3., 4., 5., 6., 7., 8., 9.]])
tensor([[0., 2., 3.],
        [4., 5., 6.],
[7., 8., 9.]])可以看到,以上操作修改了 b 的值,也影响了原张量 a 的值,所以要注意这一点,我们如果要保留原张量的值,可以使用 clone() 函数来复制一个张量。
也可以使用 reshape() 函数来改变张量的形状,reshape() 函数返回的张量与原张量不共享内存,相当于复制了一个张量,但是此函数并不能保证返回的是其拷贝值,所以官方不推荐使用。
注:使用 clone() 还有一个好处是会被记录在计算图中,即梯度回传到副本时也会传到源 Tensor 。 3. 取值操作 如果我们有一个元素 tensor ,我们可以使用 .item() 来获得这个 value,而不获得其他性质。
import torch

# 创建一个张量
a = torch.tensor([[1.0, 2.0, 3.0]
                , [4.0, 5.0, 6.0]
                , [7.0, 8.0, 9.0]])

# 复制一个张量
b = a.clone()

# 改变 b 的值
b[0, 0] = 0.0

# 查看 a 和 b 的值
print(a)
print(b)- 广播机制,PyTorch 支持广播操作,可以对不同形状的张量进行运算,如果你感觉到广播操作有些难以理解,可以简单地将其理解为对不同形状的张量进行适当的复制,使得它们的形状相同,然后再进行运算。看以下例子:
import torch

# 创建两个张量
a = torch.tensor([[1.0, 2.0, 3.0]
                , [4.0, 5.0, 6.0]
                , [7.0, 8.0, 9.0]])
b = torch.tensor([1.0, 2.0, 3.0])

# 广播操作
c = a + b

print(c)结果:
tensor([[ 2.,  4.,  6.],
        [ 5.,  7.,  9.],
[ 8., 10., 12.]])可以看到,我们对一个 3x3 的张量 a 和一个 1x3 的张量 b 进行了广播操作,得到了一个 3x3 的张量 c。
- 其他操作,PyTorch 还提供了很多其他操作,如转置、拼接、切片、矩阵分解等,这些操作可以帮助我们更方便地处理张量。
import torch

# 创建一个张量
a = torch.tensor([[1.0, 2.0, 3.0]
                , [4.0, 5.0, 6.0]
                , [7.0, 8.0, 9.0]])

# 转置
b = a.t()

# 拼接
c = torch.cat((a, b), dim=0) # 按行拼接

# 切片
d = a[0:2, 0:2] # 取第 0 行到第 1 行,第 0 列到第 1 列

# 矩阵分解
u, s, v = torch.svd(a)

# 条件筛选
e = a[a > 5]

# 上、下三角,对角矩阵获取
f = torch.triu(a) # 上三角
g = torch.tril(a) # 下三角
h = torch.diag(a) # 获取对角线元素

# 张量分块
i = torch.chunk(a, 2, dim=0) # 按行分块,分成 2 块,dim=0表示按行分块,dim=1表示按列分块

print(b)
print(c)
print(d)
print(u)
print(s)
print(v)
print(e)
print(f)
print(g)
print(h)
print(i)除开上述操作外,PyTorch 还提供了很多其他操作,很多类似于Matlab中的矩阵操作,可参考官方文档 torch.Tensor 方法。
自动求导(Autograd)
在深度学习中,自动求导是一个非常重要的功能,它可以帮助我们自动计算梯度,从而实现反向传播算法,训练深度学习模型。PyTorch 提供了自动求导功能,称为 Autograd。
Autograd 的概念
Autograd 是 PyTorch 中的自动求导模块,它可以自动计算张量的梯度,从而实现反向传播算法。在 PyTorch 中,所有的张量都有一个 requires_grad 属性,当 requires_grad=True 时,PyTorch 会自动追踪所有对该张量的操作,并自动计算梯度。
在数学中,微分是一个非常重要的概念,它可以帮助我们计算函数局部变化率,从而实现优化算法。在深度学习中,我们需要计算损失函数对模型参数的梯度,从而实现模型的训练。
在Autograd开始之前,我们需要先了解计算图的概念。 计算图是一个有向无环图,它由节点和边组成,每个节点表示一个操作,每条边表示一个张量。在 PyTorch 中,计算图是动态的,它在运行时构建,并且可以随时改变。
过于抽象?
我们把它想象成一个错综复杂的管道结构,不同的管道之间通过节点连接起来,我们有一个注水口,一个出水口。我们在入口注入数据的之后,数据就沿着设定好的管道路线缓缓流动到出水口,这时候我们就完成了一次正向传播。想象一下输入的 tensor 数据在管道中缓缓流动的场景。
在这个过程中,我们可以通过管道的每个节点,看到数据的变化,这个变化就是梯度的变化。我们可以通过这个变化来计算梯度,这就是反向传播。
而Autograd就是这个管道的设计者,他知道每个节点的作用,知道数据的流动方向,知道数据的变化,知道梯度的变化。所以他可以帮我们计算梯度。
Autograd 的使用
在 PyTorch 中,我们可以使用 torch.Tensor 是包的核心类,如果一个张量的 requires_grad=True,那么它将会追踪对其的所有操作,并自动计算梯度。
import torch

# 创建一个张量,并设置 requires_grad=True
x = torch.tensor(1.0, requires_grad=True)

# 创建一个函数 y = x^2
y = x ** 2

# 计算 y 对 x 的梯度,backward() 函数会自动计算梯度
y.backward()

# 查看 x 的梯度
print(x.grad)结果:
tensor(2.)可以看到,我们创建了一个张量 x,并设置 requires_grad=True,然后创建了一个函数 y = x^2,最后计算了 y 对 x 的梯度,得到了 x 的梯度为 2.0。
注意:
backward()函数会自动计算梯度,但是只能对标量进行求导,如果要对非标量进行求导,需要传入一个和y同形状的张量作为参数。
import torch

# 创建一个张量,并设置 requires_grad=True
x = torch.tensor([1.0, 2.0, 3.0], requires_grad=True)

# 创建一个函数 y = x^2
y = x ** 2

# 计算 y 对 x 的梯度,backward() 函数会自动计算梯度
y.backward(torch.tensor([1.0, 1.0, 1.0]))

# 查看 x 的梯度
print(x.grad)结果:
tensor([2., 4., 6.])要组织一个张量被跟踪历史,可以使用 detach() 函数,这样就可以防止梯度的传播。
import torch

# 创建一个张量,并设置 requires_grad=True
x = torch.tensor(1.0, requires_grad=True)

# 创建一个函数 y = x^2
y = x ** 2

# 使用 detach() 函数防止梯度传播
z = y.detach()

# 计算 z 对 x 的梯度
z.backward()

# 查看 x 的梯度
print(x.grad)此时运行会报错,因为我们使用了 detach() 函数,防止了梯度的传播,所以无法计算梯度。
还有一个非常重要的类 torch.autograd.Function ,Tensor 和 Function 是相互关联的,Tensor 记录了创建它的 Function,也就是创建了一个无环图,它编码了完整的计算历史。每个张量都有一个.grad_fn属性,该属性引用了创建 Tensor 自身的Function(除非这个张量是用户手动创建的,即这个张量的grad_fn是 None )。
import torch

# 创建一个张量,并设置 requires_grad=True
x = torch.tensor(1.0, requires_grad=True)

# 创建一个函数 y = x^2
y = x ** 2

print(x.grad_fn)
print(y.grad_fn)结果:
None
<PowBackward0 object at 0x00000201998CF460>可以看到,x 的 grad_fn 为 None,因为它是用户手动创建的,而 y 的 grad_fn 为 PowBackward0,因为它是通过 x 计算得到的。
如果需要计算导数,需要使用 backward() 函数,该函数会计算当前张量的梯度,然后将梯度累加到 .grad 属性中。
梯度
在 PyTorch 中,我们可以使用 backward() 函数来计算梯度,然后使用 .grad 属性来查看梯度。
数学上,梯度是一个向量,它包含了函数在每个维度上的变化率,可以帮助我们找到函数的最小值或最大值。若有向量函数
而 torch.autograd 这个包就是用来计算一些雅可比矩阵的乘积的。例如,如果
由链式法则,我们可以得到:
注意:grad在反向传播过程中是累加的(accumulated),这意味着每次运行反向传播,梯度都会累加,所以在反向传播之前需要把梯度清零。
一个简单的求梯度的例子:
import torch

# 创建一个张量,并设置 requires_grad=True
x = torch.tensor(1.0, requires_grad=True)

# 创建一个函数 y = x^2
y = x ** 2

# 计算 y 对 x 的梯度
y.backward()

# 查看 x 的梯度
print(x.grad)结果:
tensor(2.)可以看到,我们创建了一个张量 x,并设置 requires_grad=True,然后创建了一个函数 y = x^2,最后计算了 y 对 x 的梯度,得到了 x 的梯度为 2.0。
现在,我们来看一个更复杂的例子,计算一个函数
import torch

# 创建一个张量,并设置 requires_grad=True
x = torch.tensor(1.0, requires_grad=True)

# 创建一个函数 y = x^3 + 2x^2 + 3x + 4
y = x ** 3 + 2 * x ** 2 + 3 * x + 4

# 计算 y 对 x 的梯度
y.backward()

# 查看 x 的梯度
print(x.grad)结果:
tensor(10.)可以看到,我们创建了一个张量 x,并设置 requires_grad=True,然后创建了一个函数 y = x^3 + 2x^2 + 3x + 4,最后计算了 y 对 x 的梯度,得到了 x 的梯度为 10.0。
现在我们来看一个雅可比向量积的例子:
import torch

# 创建一个张量,并设置 requires_grad=True
x = torch.randn(3, requires_grad=True)
print(x)

y = x * 2
i = 0
while y.data.norm() < 1000:
    y = y * 2
    i = i + 1
print(y)
print(i)结果:
tensor([ 0.1115, -1.1299,  1.0451], requires_grad=True)
tensor([  114.1972, -1157.0621,  1070.1959], grad_fn=<MulBackward0>)
9在这个例子中,我们创建了一个张量 x,并设置 requires_grad=True,然后创建了一个函数 y = x * 2,然后不断地乘以 2,直到 y 的范数大于 1000,最后得到了 y 的值和乘法的次数。
不过,在这种情况下,y 不再是一个标量,所以我们不能直接计算雅可比矩阵,但是如果我们想要计算雅可比向量积,我们可以传递一个相同形状的张量作为参数。
import torch

# 创建一个张量,并设置 requires_grad=True
x = torch.randn(3, requires_grad=True)

# 创建一个函数 y = x * 2
y = x * 2

# 计算雅可比向量积
v = torch.tensor([0.1, 1.0, 0.0001], dtype=torch.float)
y.backward(v)

# 查看 x 的梯度
print(x.grad)结果:
tensor([2.0000e-01, 2.0000e+00, 2.0000e-04])可以看到,我们创建了一个张量 x,并设置 requires_grad=True,然后创建了一个函数 y = x * 2,然后计算了雅可比向量积,得到了 x 的梯度。